当经验可以被烧成电路|逻辑门神经网络与 TapeOut 的下一条路
AI 行业一直在做加法:更多参数、更长上下文、更多 GPU、更大的数据中心,我们也越来越习惯用规模解释智能。这篇走反方向——把经验烧成逻辑门电路,谈逻辑门神经网络与 TapeOut 的下一条路。
前言
过去几年,AI 行业一直在做加法。
更多参数,更长上下文,更多 GPU,更大的数据中心。模型越来越像一个装下半个互联网的黑箱,我们也越来越习惯用规模解释智能。
但最近我看到了一条完全反着走的路线:有人让神经网络训练完以后,把权重、矩阵乘法,甚至通常意义上的“神经元”都扔掉,最后只留下几十个 AND、OR、XOR、NAND。
https://google-research.github.io/self-organising-systems/difflogic-ca/
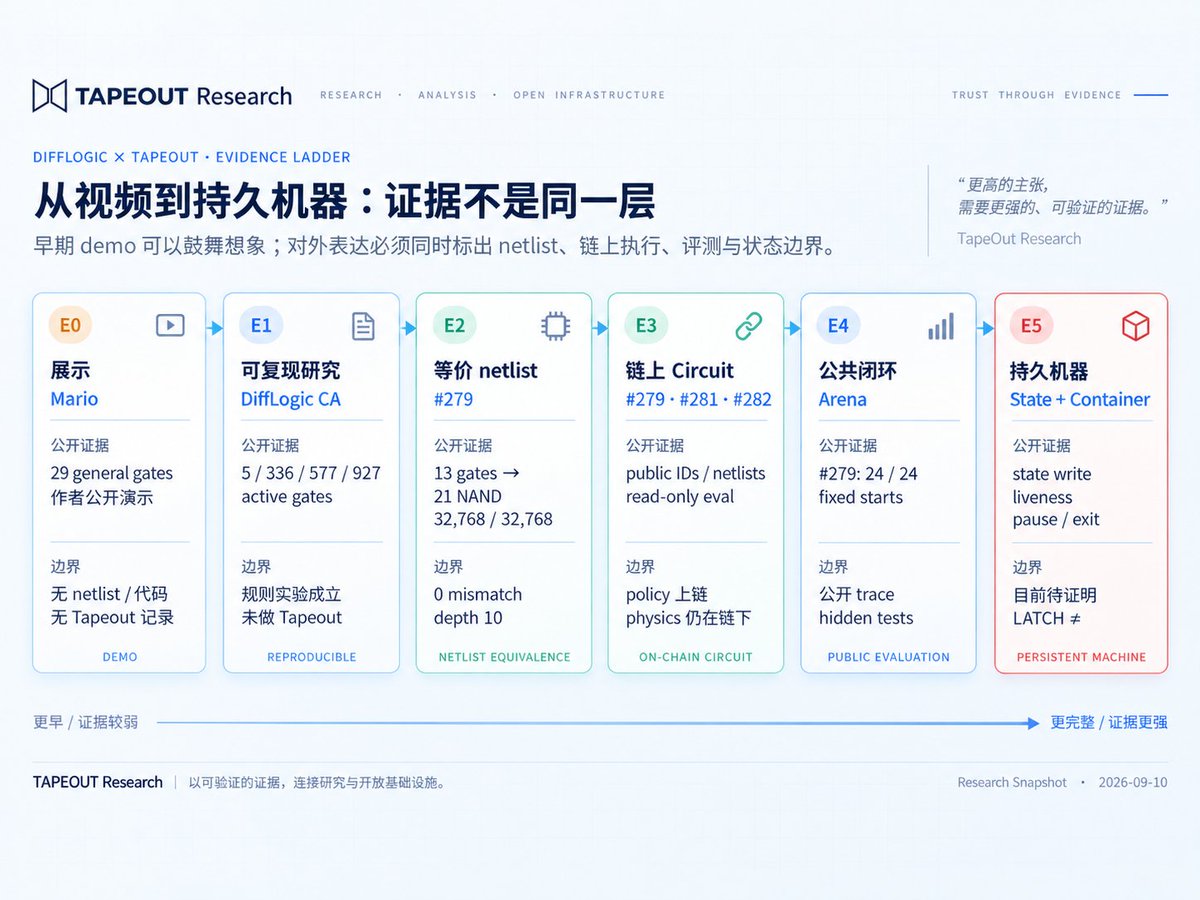
29 个逻辑门已经开始操作 Mario,作者很诚实地说,还不知道能不能通关;其日文长文同时梳理了 DLGN、卷积、循环与 Cellular Automata 的研究路线。另一位 Builder 把一个驾驶策略压成 13 个普通逻辑门,再综合成 21 个 NAND,烧录成 Tapeout Circuit #279;Microduck 又把转向与记忆拆成两个 Circuit 组合起来。
我第一反应不是“链上 AGI 来了”。
恰恰相反,这些东西离 LLM 还非常远。真正让我感兴趣的是另一个问题:
如果 AI 学到的经验,最终可以被压缩成一段极小、确定、公开、任何人都能复核的电路,那么 Tapeout 也许第一次找到了 AI 与链上硬件之间真正自然的接口。
不是把训练搬上链,也不是让区块链替代 GPU。
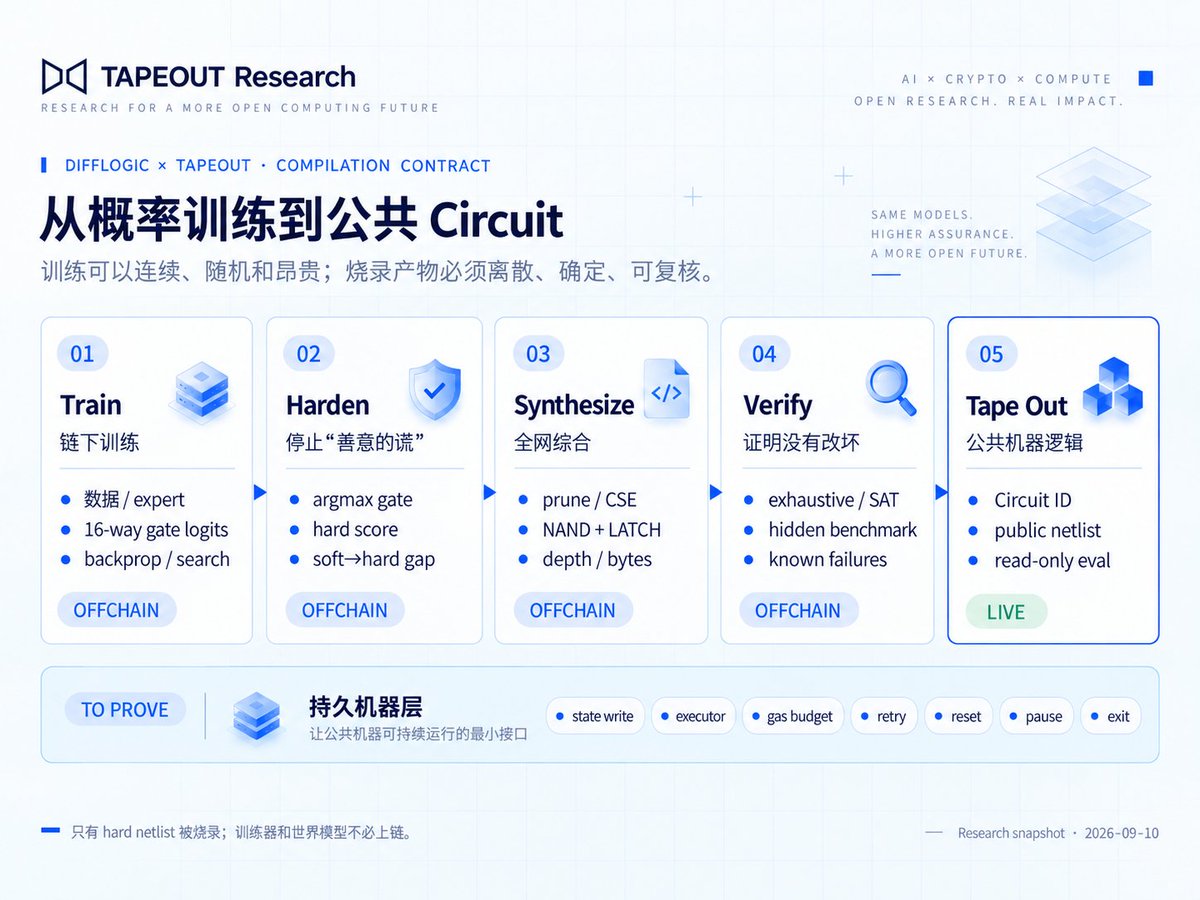
而是让 AI 在链下学习,让 Tapeout 把学到的规则烧死。
这是一件比“链上跑了个模型”更小,也可能更重要的事。
一、这种网络到底是什么
它的名字叫 Differentiable Logic Gate Network,可微逻辑门网络。
传统神经网络的一个节点,通常要接收许多输入,乘以权重,相加,再通过激活函数。逻辑门网络没有这套东西。每个节点只有两个输入,执行 16 种两输入 Boolean function 中的一种,例如 AND、OR、XOR、NAND。
问题是,逻辑门是离散的。AND 就是 AND,不会因为梯度下降突然变成 0.37 个 AND 加 0.63 个 XOR。
研究者于是做了一件很聪明、也很“AI”的事:训练时先撒一个善意的谎。
原本只能接收 0 和 1 的逻辑门,被暂时放松成 [0,1] 上的连续函数。每个节点不立刻选择某一种门,而是先保留一组概率,用反向传播慢慢调整。
训练结束,谎话停止。每个节点只保留概率最高的那个门:
https://zenn.dev/teba_eleven/articles/68955053ed75be
浮点数、softmax、梯度和 Adam 全部退出舞台,剩下的是一张纯 Boolean circuit。
“After training, the resulting network is discretized to a hard logic gate network by choosing the logic gate with the highest probability.”Petersen et al., Deep Differentiable Logic Gate Networks
所以它和 BNN:二值神经网络——不是一回事。BNN 仍然是权重网络,只是把权重或 activation 压成 ±1,再用 XNOR 与 popcount 加速;逻辑门网络没有传统权重,学的就是每个位置究竟放哪一种门。
BNN 是把神经网络变得更像数字电路;DLGN 是直接让数字电路成为模型。
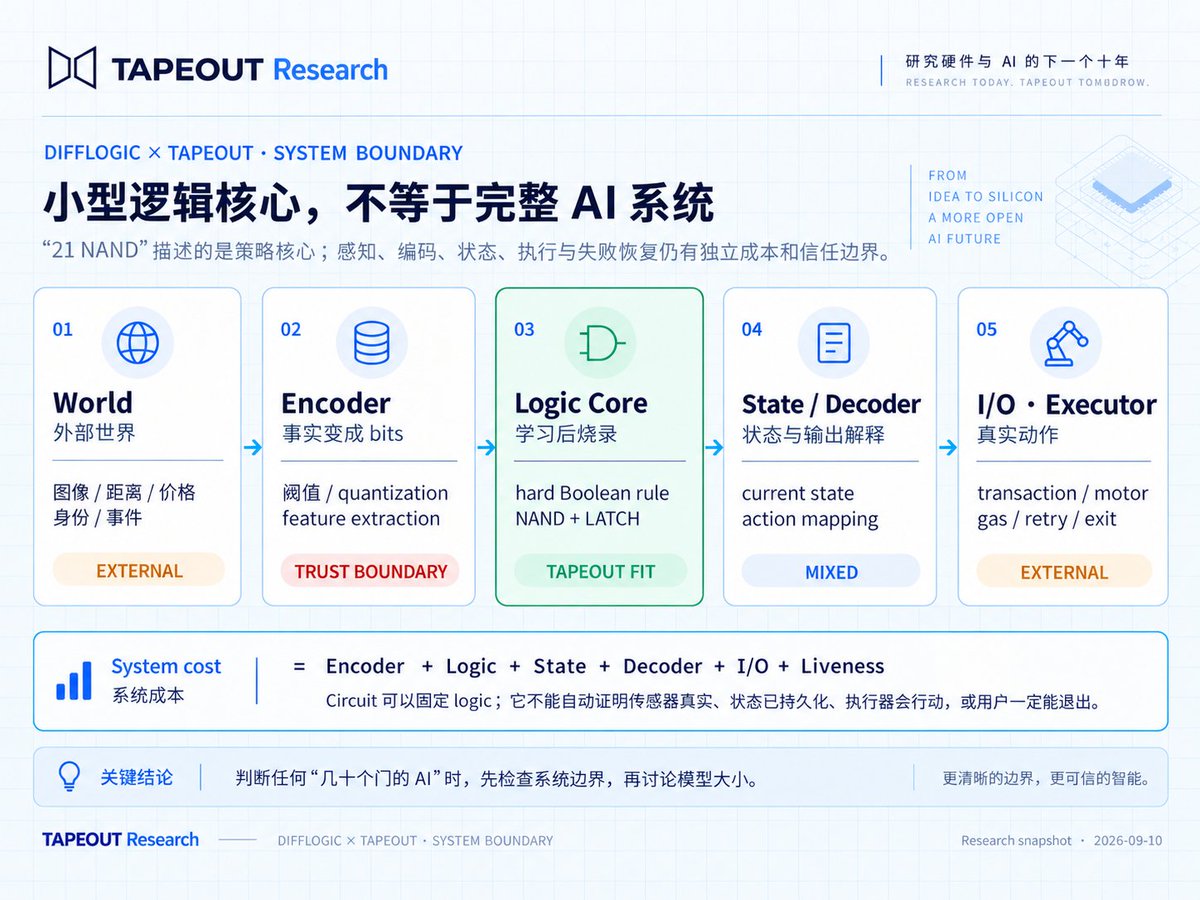
但这里必须立刻划一条系统边界。
小型逻辑核心,不等于完整 AI 系统。
一个 20-gate controller,通常只意味着它的 logic core 很小,不等于整套 AI 系统只有 20 个门。真实系统至少包括:
图像怎样变成阈值、距离怎样变成 bits、状态由谁保存、动作由谁提交,成本和信任都没有因为核心电路很小而消失。以后看到“29-gate Mario”或“21-NAND Driver”,首先要问的不是门有多少,而是:哪些功能被算进来了,哪些仍留在浏览器、传感器、CPU 或执行者那里。
二、研究已经从“能不能学”走到了“能不能综合”
这条路线并不是突然从 X 上冒出来的玩具。
2022 年,Petersen 等人证明 Deep DLGN 可以通过连续松弛训练,并在单 CPU core 上以超过百万张 MNIST/秒的口径推理。但这个数字需要正确理解:它依赖把许多样本 bit-pack 进 int64,一次位运算并行处理一批数据,不等于一张图片在 EVM 上逐门跑也会这么快。
2024 年,Convolutional DLGN 加入 logic gate tree convolution、OR pooling 和 residual initialization,把 CIFAR-10 做到 86.29%,使用 6,100 万个逻辑门;其中较小模型在 FPGA 上达到 24 ns/image,MNIST 模型达到 5 ns/image。
它证明逻辑门模型可以成为高效硬件,却也顺便提醒 Tapeout:FPGA 上“只有 6,100 万个门”已经很小,逐门上链却大得近乎荒谬。硬件效率与链上可承受规模不是同一个坐标系。后续扩展研究还指出,类别数增加时,GroupSum 一类输出聚合也会成为门数和训练稳定性的瓶颈;不能只数 hidden gates。
2025 年,Recurrent DLGN 开始处理序列。它在受限的 WMT’14 英德翻译实验中使用约 152.6 万个逻辑门,但句子被限制在 16 tokens,离散后 BLEU 只有 4.39,并且 16,000 词的 embedding table 仍然占据主要模型体积。
这可以叫“Boolean recurrence 的 proof-of-concept”,不能叫“逻辑门 LLM”。如果有人把它直接写成 ChatGPT 即将被 NAND 取代,大概是 NAND 自己看了都会有点不好意思。
真正接近 Tapeout 的,是 Google 的 Differentiable Logic Cellular Automata。它让每个 cell 持有若干二进制 state bits,再用两段学习出来的 Circuit 完成局部感知和状态更新;同一规则在空间和时间上不断复用。
后续研究暴露了最实际的困难:soft model 表现好,不代表离散后的 hard circuit 也好。NeurIPS 2025 的 Mind the Gap 在 CIFAR-10 上观察到接近 3% 的 soft-hard gap,并通过 Gumbel noise 与 straight-through estimator 将实验中的 gap 降低 98%、收敛速度提升约 4.5 倍。
到了 2026 年,Light DLGN 继续改写 gate parameterization,以更轻的结构和更稳定的训练逼近原有精度;另一项工作则开始同时学习 gate type 和 wiring。一个 fully trainable DLGN 在 MNIST 上用两层、每层 8,000 gates 做到 98.92%,相较原始固定连接方案的 384,000 gates,门数缩减接近 50 倍;同一工作也直接训练 6-input LUT 网络。
换句话说,这条赛道真正的前沿已经不是“逻辑门能不能学”,而是:
怎样让它学完以后,真的只剩一张足够小、足够确定、足够容易验证的电路。
更准确地说,这是一种 Machine Learning as Circuit Synthesis:机器学习负责发现可能有效的行为,EDA 负责寻找更便宜的实现,形式方法负责证明编译过程没有改坏机器,Tapeout 则把最终产物变成公共记录。DLGN 不是来替代 Yosys 或 ABC 的;它解决“应该实现什么行为”,传统逻辑综合解决“怎样用更少的门实现这个行为”。
https://jogjohgoeg.github.io/nand-driver/
三、Tapeout 为什么正好卡在训练和执行之间
大模型擅长的是概率。
它可以根据海量经验给你一个大概率正确的答案,也会在某些非常自信的时刻胡说八道。区块链和数字电路擅长的是另一件事:同样输入必须给出同样输出,规则写成什么,就只能执行什么。
两者真正自然的分工,不是互相替代:
我愿意把最终留下来的东西叫作可烧录的经验。
它不是完整智能,更像机器的反射弧:看到某组 bits,必须左转;触发某个风险条件,必须拒绝;当前状态与邻居状态满足某些组合,下一步必须写入某组 bits。
这种机器反射有三个特征:
- 它可以从数据中学出来,不一定由人手写。
- 它一旦离散化,就是一张可以穷举、综合、挑战的逻辑图。
- 它足够小的时候,可以被 Tapeout 变成公共 Circuit,而不是继续躺在某家公司随时能替换的服务器里。
这正是 Tapeout 比“普通 AI API”多出来的东西:API 告诉你今天模型说了什么;Circuit 让所有人知道,这条规则到底由哪些门组成,它有没有变,以及同样输入明天会不会得到同样答案。
四、21 个 NAND 的汽车,真正证明了什么
目前最完整的实例不是 Mario,而是 Circuit #279。
Builder 先用 15 bits 描述赛道:五条 ray,每条 ray 三个距离阈值。输出只有两 bits:左转和右转。
https://arxiv.org/html/2508.06097v1
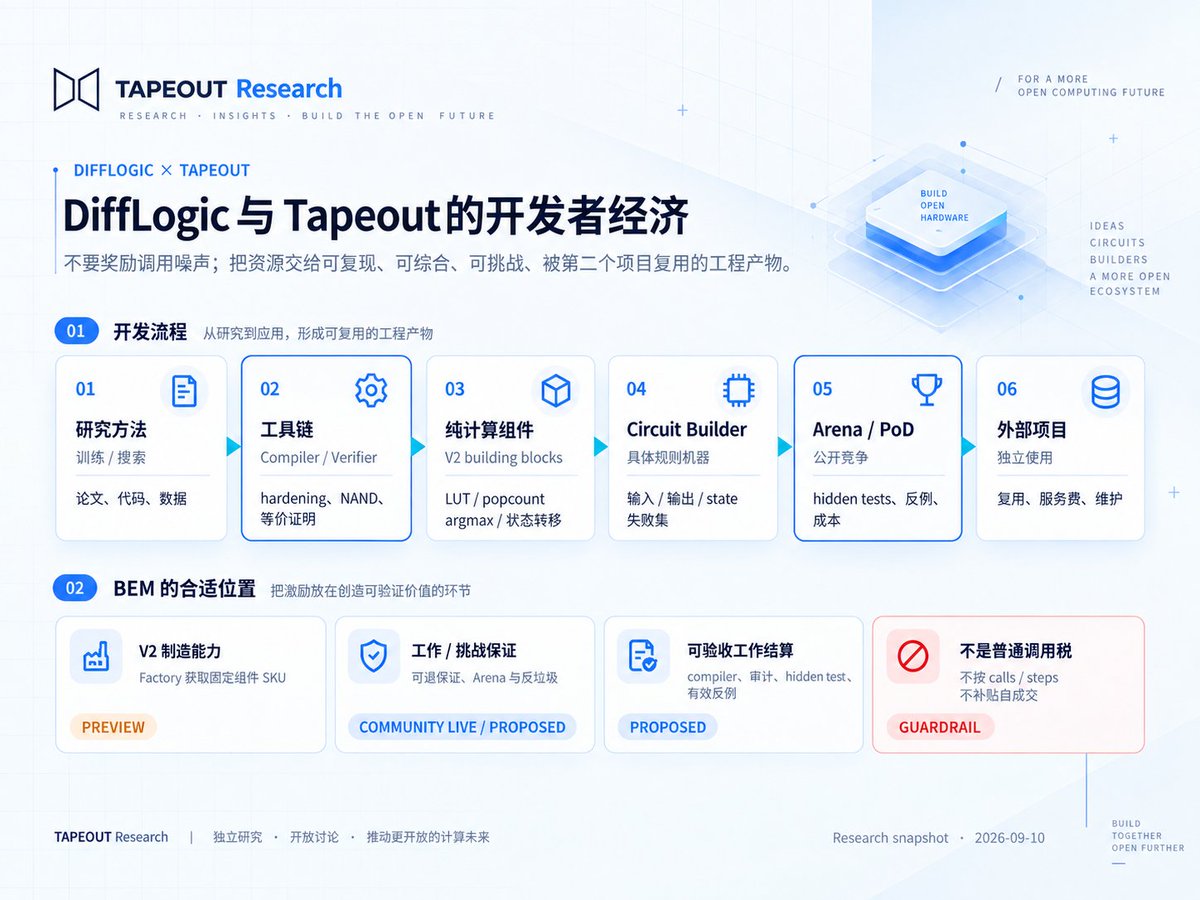
最值得看的不是“汽车会动”,而是从模型到电路的证据链。
13 个普通 Boolean gates 如果逐个按最坏上限替换,可能需要 65 个 NAND。Builder 通过全网共享、常量折叠和无效门删除,把它压到 21。这说明以后 PoD 真正应该竞争的不是论文里写了多少 neurons,而是最终烧录需要多少 NAND、多少 LATCH、多少层深度、多少 bytes。
它还对全部 32,768 个输入做了 exhaustive equivalence,不是随机抽几个样本说“应该差不多”。2026 年 9 月 10 日 16:52 GMT+8,我又通过 BSC 只读 RPC 调用 #279 的公开示例输入 0xf937,链上返回一个 byte 0x00,与页面的“不转向”一致。
但边界同样需要写清楚。
赛道和 physics 在浏览器;Circuit 只负责 policy。模型来自手写 expert,只在一个 track family 上拟合,没有 held-out track,并且仍有 6 个罕见输入与 expert 不一致。它证明的是:
一个学习出来的控制策略,可以被精确压缩、烧录并公开调用。
它没有证明一个 21-NAND 汽车已经学会面对开放世界。
五、Microduck 又向前走了半步:Circuit 开始组合,记忆还没真正上链
Microduck 的结构更有意思。
https://github.com/Felix-Petersen/difflogic
#281 用 39 个 NAND 处理 14-bit virtual depth 与目标方向,输出 steering;#282 用 22 NAND + 3 LATCH 添加一个固定的转向记忆规则。CircuitGraph 再把两块分别烧录的 Circuit 串起来。
这证明了两个重要方向:学习策略可以被独立烧录;状态规则可以作为第二块 Circuit 与第一块组合。
但公开页面也写得很清楚:传感、行走、physics 和上游 ONNX gait model 都在浏览器或本地;on-chain mode 每一步只是 read-only CircuitGraph call;trial memory 由浏览器传给下一步,合约的 callerState 从未写入,刷新即清除。
所以它现在是带 LATCH 语义的组合控制原型,还不是拥有持久链上记忆的机器。
这个区分看似扫兴,实际上更有价值。因为它把 Tapeout 的下一道工程题暴露出来了:不是再做一个更大的模型,而是把 policy、state、account 与 executor 的责任真正拆开。
六、DiffLogic CA:可能是比“链上 LLM”更适合 Tapeout 的远方
Google 的 DiffLogic CA 做了一组很漂亮的实验。
它先让模型学习 Conway’s Game of Life 的局部规则。3×3 neighborhood 只有 2^9 = 512 种可能输入,训练集覆盖全部配置,最终 hard circuit 可以在更大网格上生成 glider、block 和 oscillator。项目报告 336 个 active gates。
更令人意外的是 checkerboard:8-bit cell state,在 16×16 网格上运行 20 steps。训练后有 22 个 active gates,继续剪枝只剩 6 个,其中 1 个还是冗余的,最后等价于 5 个有效逻辑门。把网格和时间同时放大 4 倍,它仍然工作;局部 cells 被破坏后,它还能维持或恢复图案。
这很容易让人产生“链上可编程生命”的想象。但先别急。
规则只有 5 个门,不代表 64×64 个 cells 跑 80 steps 也只需要 5 个门。整体执行成本更接近:
https://arxiv.org/html/2506.07500v1
这也是 DiffLogic CA 与 Tapeout 最值得结合的地方:同一小 Circuit 可以被大规模复用,但复用不是免费。
近期最现实的路线不是先做蜥蜴、彩色图案或“链上生命”,而是从极小状态机开始:
如果这条路成立,Tapeout 可能不只是保存函数,而开始保存可以在时间里反复生长的规则。
这比“上链一个大模型”慢得多,也硬得多。但至少它面对的是一个真实问题,而不是给 AI 和区块链两个热门词安排一次相亲。
七、开发者应该怎样开始
第一次做,不要碰图像分类,更不要碰 LLM。选一个输入不超过 16 bits、输出不超过 4 bits、能做全量验证的任务。
- 第一步:定义输入,而不是先写模型
每一个 bit 都要写清名称、阈值、单位、顺序和缺失值。外部世界不是天然 Boolean 的;传感器、价格、身份和事件怎样变成 bits,本身就是可信边界。
- 第二步:按环境切分数据
不要把相邻帧随机分进 train 和 test。驾驶任务按 track 或 episode 切分;机器人按场景切分;Agent 权限按资产、地址和异常类型切分。
- 第三步:先训练小模型
基础 DLGN、Gumbel LGN、Light DLGN、AP、evolutionary search,甚至手写规则都可以。训练算法不应该成为协议信仰。Tapeout 最终只看你交付的 hard circuit 和证据。
- 第四步:同时报告 soft 与 hard
只有 hard score 才是未来会被执行的机器。
- 第五步:综合,而不是翻译
不要把 DLGN 的每个节点直接逐门换成 NAND。一个可靠工具链至少需要六层语义彼此分开:
Boolean IR 应先保留 NOT、AND、OR、XOR、constants、input、output 与 state 的语义,再执行 constant propagation、dead-code elimination、structural hashing、公共子表达式共享和 critical-path analysis;之后才交给 Yosys/ABC 一类 EDA 工具做全局优化与 NAND technology mapping。
原因很简单:逐门成本相加,不等于全网综合成本。多个节点可能共享同一个 inverter,dead branch 会被完全删除,一个看似昂贵的 XOR 也可能在全局 Boolean factoring 后变便宜。
有状态逻辑则应显式写成:
- 第六步:证明 compiler 没有改坏模型
小输入域直接穷举;大输入域构造 miter circuit,再用 SAT/SMT、property tests 和 counterexample replay。最好不要只验证最后一跳,而是逐层检查:
这里还必须区分三件经常被混在一起的事:
等价证明只能说明 compiler 忠实复制 hard model,不能证明 hard model 本身学对了,更不能自动证明它安全。
- 第七步:最后才 Tape Out
先做本地 replica,再做 read-only eval,再进入公共 Arena,最后才考虑持久 state、Container 和外部资产。
完整开发步骤、manifest 字段、NAND lowering、测试与提交清单,我已经单独整理成开发者指引,避免让教程把这篇文章吞掉。
https://arxiv.org/pdf/2411.04732
八、PoD 应该怎样接住学习型 Circuit
PoD (Proof of Design) 现在最迷人的地方,是它不奖励“最早占位”,而奖励同一公开任务下成本严格更低的当前最优。后来者可以超越,旧设计仍留在已验证池。
这个哲学非常适合逻辑综合,却不能直接把机器学习 accuracy 塞进成本公式。
开放任务没有绝对 correctness,公开测试集还会被过拟合。更合理的结构是:先达标,再比成本。
同一个任务可以有 90%、95%、99% 三个性能档。在同一档内,再按 NAND、LATCH、depth、bytes 和最坏状态更新成本竞争。
真正应该公开的主图,也不再只是 accuracy curve,而是 hard task performance 与 post-synthesis NAND count 的 Pareto frontier。处在边界之外的方案,要么性能更差,要么成本更高;处在边界上的方案,才代表当前“这份行为最少需要多少物理逻辑”的有效答案。没有真实 benchmark 数据时,只能先发布坐标与规则,不能为了好看制造散点。
训练集可以公开,隐藏环境应先 commit hash、赛后 reveal;严重安全违规不能被平均 accuracy 抵消。一个控制器越权一次,不应该用另外 99 次没越权来安慰自己。
如果协议当前的 PoD 合约还不支持这些条件,就先在外部 Arena 跑,等规则、referee 和反例机制成熟后再谈协议级整合。不要让叙事跑在验证器前面。
https://x.com/Blonskr/status/2092551495392825791
九、V2 组件真正应该卖什么
官方 V2 预告中,第三方可以开发确定性、纯计算、无管理员、非代理的固定规格组件;Factory 使用 BEM 获取组件制造能力,用户用 BNB Mint,协议费的一部分按公开方向转换为 BEM 分给组件开发者。
这里最容易犯的错误,是把一个 6,100 万门的图像模型封装成“AI 组件”,然后庆祝复杂性被隐藏了。
隐藏不是消失。
DiffLogic 真正适合 V2 的,是那些大量模型都会重复使用的纯计算积木:
这些东西不负责训练,也不保存外部状态。它们负责把已经确定的逻辑,以固定 SKU 和固定接口提供给下一台 Circuit。
V2 若能做到这一点,Tapeout 会出现一条很具体的开发者链条:
再往前一步,可以研究一类 Tapeout-aware logic training。普通模型只优化任务损失;面向 Tapeout 的训练器可以加入预期 NAND、深度、状态与 soft-hard gap 的代理成本:
但必须强调:这是本文提出的研究方向,不是现有论文已经验证的标准方法。逐节点 expected NAND cost 只能做内层 proxy;每隔若干 checkpoint 进行 hard collapse 和真实 Yosys/ABC 综合,再观察最终 NAND 与 depth,才可能校准代理成本。真实综合不可微,这种双层优化的稳定性、频率和计算开销都仍待实验。
这时候 BEM 才有一个比“AI narrative”更扎实的位置:不是每调用一次都交 BEM 税,而是在 Factory 获取组件制造能力、Builder 提交可退工作保证、Arena 进入挑战,以及通过验收的 compiler、审计与反例工作中承担结算。
调用量最容易刷,经过独立验收的工程改进最难刷。
https://x.com/Tebasaki_lab/status/2096987015976022198
十、这条路也有危险的地方
我对这个方向很兴奋,但有六件事必须先写出来。
- 输入编码可能比模型更不可信。Circuit 可以保证同样 bits 得到同样输出,不能保证 oracle、摄像头、价格源或浏览器没有撒谎。
- soft model 与 hard circuit 可能是两个东西。只放训练 accuracy,不放离散 accuracy,是这类项目最容易出现的新式美化。
- 公开 benchmark 会被记忆。Mario 视频、固定赛道和公开数据都可以做展示;要证明泛化,必须有 commit-reveal hidden environments 和持续反例。
- 论文 gate count 不是 Tapeout 成本。一般 Boolean gate 要 lower 成 NAND,输出还需要 aggregation;Cellular Automata 则要乘 cells 与 steps。
- LATCH 不等于持久机器。状态由谁保存、谁触发、谁付 gas、失败怎么重试、谁能 reset 和 exit,必须单独设计。
- 代码许可不等于方法权利没有问题。官方 difflogic 仓库使用 MIT License,但 README 同时写有 Patent pending;组件商业化前需要独立做权利核查。
此外还要记住两组不等式:
NAND 可以表达任何 Boolean function,不代表学习器能从有限样本找到正确函数。一个两千万门的确定电路,同样可能没人能读懂;逻辑门网络真正增加的是可被形式操作、综合与挑战的能力,不是天然的人类可解释性。
这些不是为了给想象力泼冷水。
恰恰相反,一条新路线只有把失败条件提前说清楚,才有机会从一次漂亮 demo 变成真正的开发者生态。
十一、我更愿意怎样想象 Tapeout 的未来
未来的大模型大概会越来越大,越来越聪明,也越来越像水电煤一样由少数基础设施提供。
但不是每一个动作都需要重新问一次大模型。
当经验被反复验证以后,其中一部分会从“智能”沉淀成“规则”:一个机器人遇到障碍时的反射,一套 Agent 永远不能越过的资金边界,一个 DeFi 策略在极端输入下的拒绝条件,一组局部 cells 怎样从损坏中恢复的状态转移。
大模型负责继续学习,Circuit 负责守住已经学会的东西。
https://arxiv.org/html/2607.09399v1
这不是 AI 的对立面。
它更像 AI 走出实验室以后,必须穿上的第一件工装:聪明可以继续变化,真正影响资产、机器和公共系统的那几条边界,最好不要跟着 prompt 一起漂移。
如果这条路线走通,Tapeout 最终保存的也许不只是电路。
它会保存一代又一代 Builder 从数据、错误和反例中压缩出来的经验:谁先发现,谁把它做得更小,谁在隐藏环境里证明它仍然有效,谁又用一个新的反例把旧的最优拉下位置。
过去的数字电路,大多是 Human-designed Circuits:人定义逻辑,EDA 负责压缩。下一类产物可能是 Machine-discovered Circuits:人定义环境、目标和禁区,学习器发现行为,EDA 将行为综合成机器,形式方法验证实现,Tapeout 记录版本与所有权。
如果未来这些 Circuit 进一步拥有经过审计的持久状态、账户边界与 Container,它们才可能从“可验证函数”走向“可拥有的学习机器”。但这里的顺序不能倒过来:先证明 logic,再证明 state,再证明 liveness 和 exit,最后才谈资产与 Agent。一个漂亮的名字不能替代一条完整的退出路径。
神经网络把世界学成概率。
Tapeout 再从这些概率里,挑出少数值得永久留下的规则。
智能的上限也许属于更大的模型;但智能进入现实世界的边界,可能属于那些最小、最笨、也最不肯改口的电路。
这才是逻辑门神经网络与 Tapeout 最让我着迷的地方。
不是 NAND 即将取代 AI。
而是 AI 终于有机会,把自己真正学会的那一小部分,交给 NAND 保管。 #TapeOut #BNB #BNBChain
References
[1] Tebasaki — 29 logic gates begin controlling Mario
[2] A car that drives on 21 NAND gates
[3] A duck with a gate brain
[4] Deep Differentiable Logic Gate Networks ,NeurIPS 2022
[5] Convolutional Differentiable Logic Gate Networks ,NeurIPS 2024
[6] Recurrent Deep Differentiable Logic Gate Networks ,2025
[7] Differentiable Logic Cellular Automata ,Google Research
[8] Mind the Gap: Removing the Discretization Gap in DLGNs ,NeurIPS 2025
[9] Fully Trainable Deep Differentiable Logic Gate Networks and Lookup Table Networks ,2026
[10] Tapeout PoD formula and task entry
[11] Tapeout Protocol V2 核心预告
[12] difflogic official implementation
[13] Tebasaki — Logic-gate neural network outlook
[14] Light Differentiable Logic Gate Networks ,ICLR 2026
[15] From MNIST to ImageNet: Understanding the Scalability Boundaries of DLGNs